Ciberseguridad · Acústica forense
La voz, como nuevo vector de ataque
Clonación de voz, inteligencia artificial y los nuevos desafíos de la ciberseguridad y la acústica forense.
Introducción
Durante décadas hemos considerado la voz como una de las manifestaciones más reconocibles de nuestra identidad. Identificamos a familiares, compañeros de trabajo o personas conocidas por su timbre, entonación, ritmo de habla y particularidades fonéticas. Escuchar una voz familiar genera confianza, incluso cuando no podemos ver a quien está hablando.
Pero ¿qué ocurre cuando esa voz puede ser reproducida artificialmente?
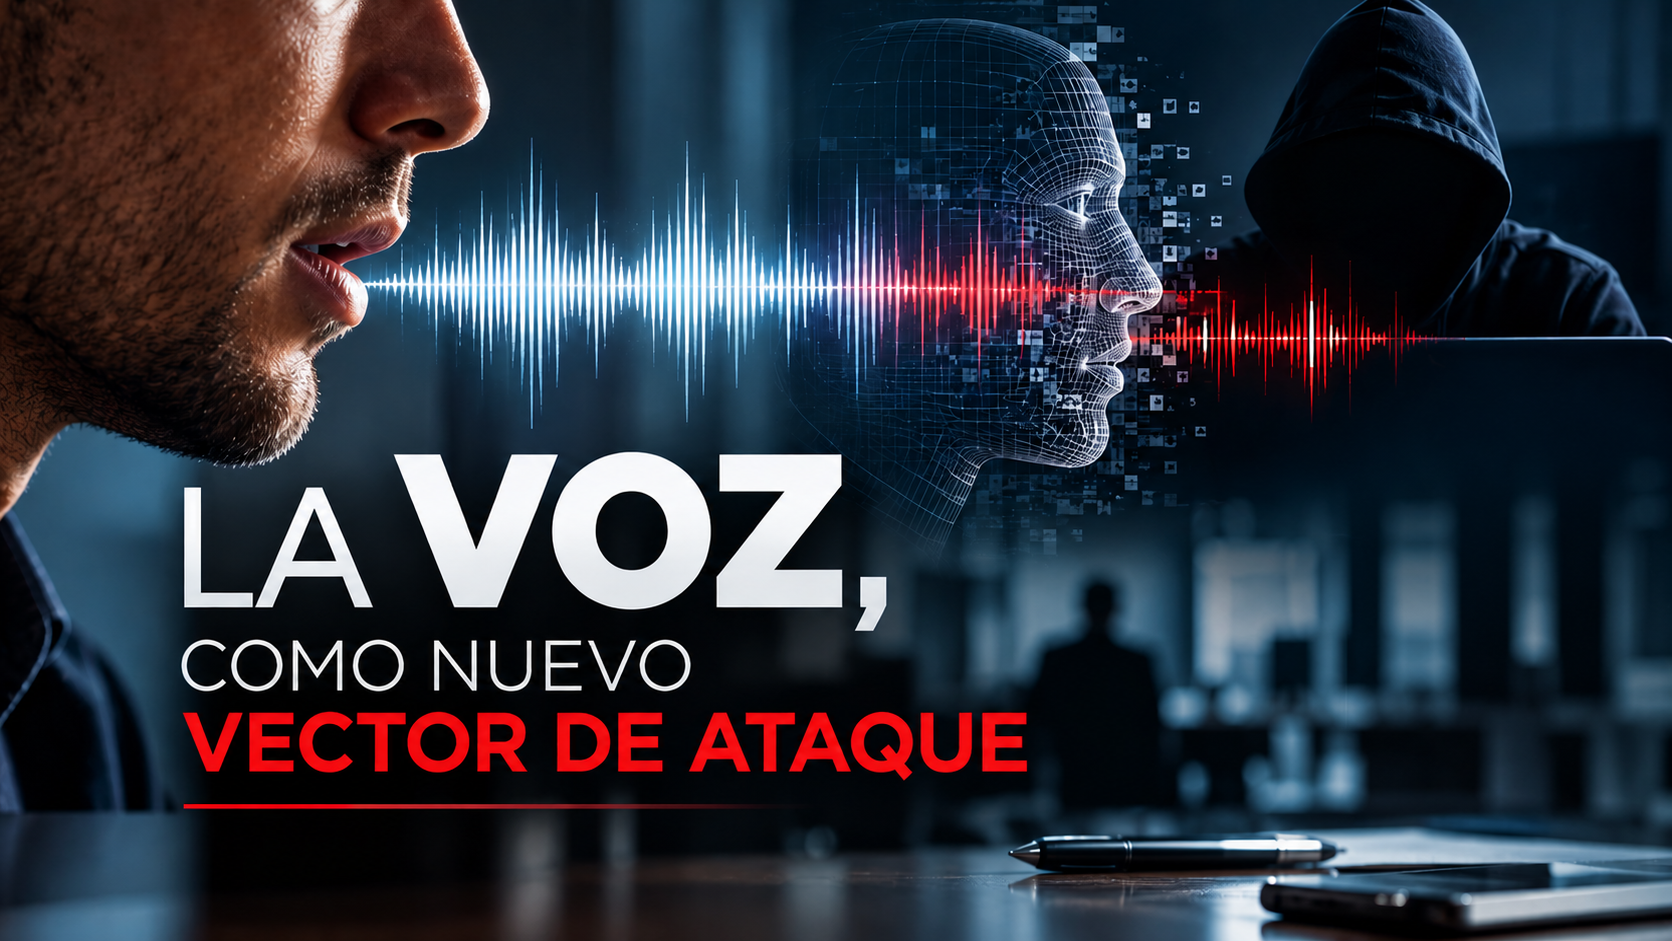
La evolución de la inteligencia artificial generativa ha transformado las posibilidades de síntesis y clonación vocal. Hoy existen sistemas capaces de generar discursos que reproducen con notable fidelidad características de un hablante, incluyendo rasgos prosódicos, pausas, énfasis y determinadas expresiones emocionales. Estas tecnologías ofrecen aplicaciones legítimas, pero también introducen nuevas amenazas: suplantaciones de identidad, fraudes económicos, campañas de descrédito y fabricación de evidencias sonoras. La voz ha dejado de ser únicamente un atributo de identidad para convertirse también en un potencial vector de ataque. Y esta transformación plantea una cuestión especialmente relevante para la acústica forense:Cuando escuchamos una grabación, ¿podemos asegurar que la persona cuya voz reconocemos pronunció realmente esas palabras?
La voz como instrumento de ingeniería social
En ciberseguridad, un vector de ataque es el medio utilizado para explotar una vulnerabilidad y comprometer un sistema, una organización o una persona. La voz presenta una particularidad: explota directamente nuestros mecanismos de confianza. Una llamada telefónica del director general, una nota de voz de un compañero o un mensaje de un familiar pueden desencadenar respuestas inmediatas sin que el receptor cuestione la identidad de quien habla. Los sistemas de clonación vocal permiten aprovechar esta vulnerabilidad mediante técnicas de ingeniería social. Pensemos en un responsable financiero que recibe una llamada de quien parece ser el director general de su empresa. Reconoce su voz, su manera de expresarse e incluso determinados giros lingüísticos habituales. La llamada transmite urgencia y solicita una transferencia confidencial. El atacante está utilizando la voz como una credencial de autoridad. Esta modalidad de suplantación, conocida como fraude del CEO, demuestra que los procedimientos de seguridad basados únicamente en el reconocimiento de una voz conocida resultan insuficientes. Algo similar sucede con el vishing, modalidad de fraude telefónico que puede apoyarse en voces sintéticas para simular llamadas de familiares, empleados de entidades bancarias o personas de confianza. En muchas ocasiones basta con convencer a una persona; no es necesario superar un sistema biométrico.Clonación de voz: cuando la inteligencia artificial aprende a hablar por nosotros
El ataque reputacional: una grabación falsa puede desencadenar una crisis real
«Esa no es mi voz»: la nueva coartada judicial
La inteligencia artificial generativa introduce una paradoja en el ámbito judicial. Por una parte, permite fabricar grabaciones que aparentan documentar conversaciones inexistentes. Por otra, facilita que una persona cuestione una grabación auténtica alegando que su voz ha sido clonada. Este fenómeno se relaciona con el concepto de liar's dividend: la posibilidad de obtener una ventaja desacreditando evidencias auténticas gracias a la existencia de tecnologías capaces de generar falsificaciones convincentes. La mera existencia de herramientas de clonación vocal no demuestra que una grabación concreta sea falsa. Del mismo modo, la semejanza entre una voz grabada y la de una persona tampoco acredita por sí sola la autenticidad del archivo. La identidad vocal, la integridad de una grabación y la posible existencia de contenido sintético son cuestiones periciales diferentes. La valoración requiere examinar procedencia, condiciones de adquisición, transformaciones e indicios técnicos.No basta con afirmar que una voz pertenece o no a una persona: hay que establecer qué puede demostrarse científicamente sobre la grabación.
Identificar a un hablante no significa demostrar que su voz sea real
En el análisis comparativo de hablantes se estudian características de dos muestras vocales para evaluar la evidencia respecto a hipótesis sobre su origen. Pueden utilizarse parámetros como la frecuencia fundamental (F0), frecuencias formánticas, patrones prosódicos y características de fonación. También existen sistemas automáticos que emplean modelos estadísticos y razones de verosimilitud (likelihood ratios).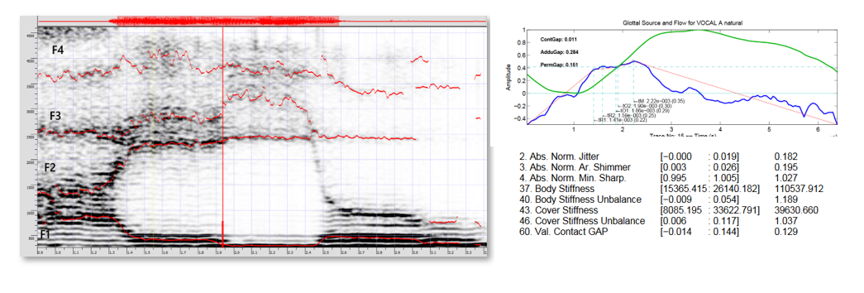
Cuando dos análisis parecen contradecirse
Consideremos una muestra original y otra generada mediante clonación de esa voz. Un sistema de comparación podría ofrecer un resultado favorable a la hipótesis de un mismo origen vocal, mientras que un análisis independiente podría identificar indicios de generación artificial en la segunda muestra. No necesariamente existe contradicción: el primer sistema evalúa semejanzas relacionadas con identidad vocal y el segundo examina características vinculadas al proceso de generación. Una voz puede parecerse extraordinariamente a la de una persona sin corresponder a una emisión natural realizada por ella.¿Podemos distinguir una voz humana de una voz sintética?
La detección automática de voz sintética es un campo activo de investigación. Existen modelos entrenados con grabaciones naturales y artificiales que buscan patrones asociados a procesos de síntesis, incluidos indicios espectrales y temporales que pueden pasar inadvertidos en la escucha. Su capacidad no es universal: el rendimiento depende del sintetizador, los datos de entrenamiento, la duración de la muestra y las transformaciones posteriores.El riesgo de interpretar incorrectamente los porcentajes
Si una herramienta devuelve una puntuación del 94 %, no significa necesariamente que exista un 94 % de probabilidad de que el audio sea falso. Puede tratarse de una puntuación interna, un nivel de confianza del clasificador o una estimación calibrada bajo determinadas condiciones.El verdadero reto forense: los audios híbridos
Uno de los mayores desafíos aparece cuando contenido sintético se incorpora a una grabación real. Imaginemos una conversación auténtica en la que se sustituyen unas palabras o una frase mediante clonación vocal. El resto conserva voz original, pausas y sonidos ambientales. Este audio híbrido puede ser difícil de detectar con herramientas que analizan el archivo globalmente. El ruido ambiental, la simulación de canales telefónicos, la reverberación, la mezcla con grabaciones reales y la recodificación con pérdida pueden modificar patrones que determinados detectores utilizan. Una manipulación localizada puede pasar inadvertida si el análisis se limita a una puntuación global. Resulta importante examinar cómo evolucionan los indicios de síntesis a lo largo del tiempo. Un análisis de integridad de audio profundo debería incluir el análisis temporal y las variaciones de trazas de síntesis a lo largo de una grabación. Una forma de representarlos es el spoofgrama: una representación temporal de puntuaciones obtenidas por un detector de suplantación o síntesis vocal sobre diferentes segmentos.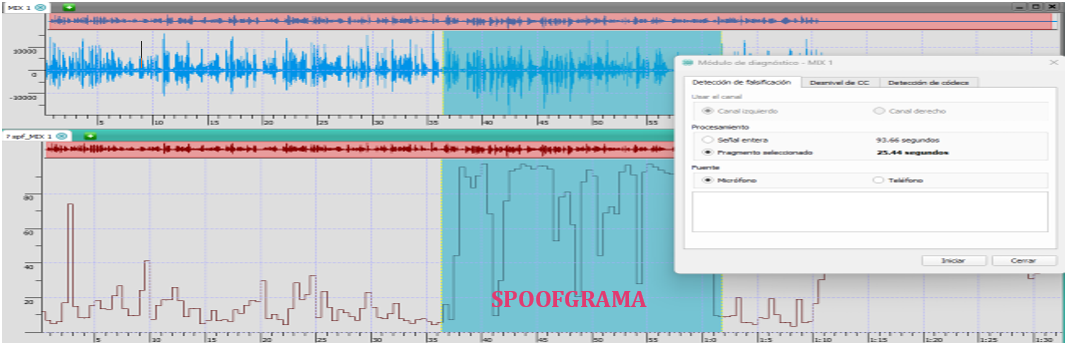
Una perspectiva integral
La autenticidad de la evidencia sonora debe abordarse desde una perspectiva integral, no mediante un único procedimiento o detector.-
01
Análisis de integridad
Investiga discontinuidades, ediciones, cambios de codificación y otras alteraciones en el dominio de la amplitud, la frecuencia y la fase acústica, interpretadas a la luz de las condiciones de adquisición y transmisión.
-
01
-
02
Comparativo de hablantes
Evalúa semejanzas y diferencias bajo hipótesis de identidad, sin certificar por sí solo la autenticidad.
-
02
-
03
Detección de síntesis vocal
Forma parte de una metodología de trabajo, dentro de un procedimiento de análisis estructurado, auditable y reproducible por un tercero si así lo requiere la autoridad judicial.
-
03
-
04
Preservación de la evidencia
Garantiza la trazabilidad y la cadena de custodia, con la norma ISO/IEC 27037 como marco de referencia para el tratamiento de evidencias digitales: procedimientos trazables, reproducibles y defendibles.
-
04
Conclusión: ya no basta con reconocer una voz
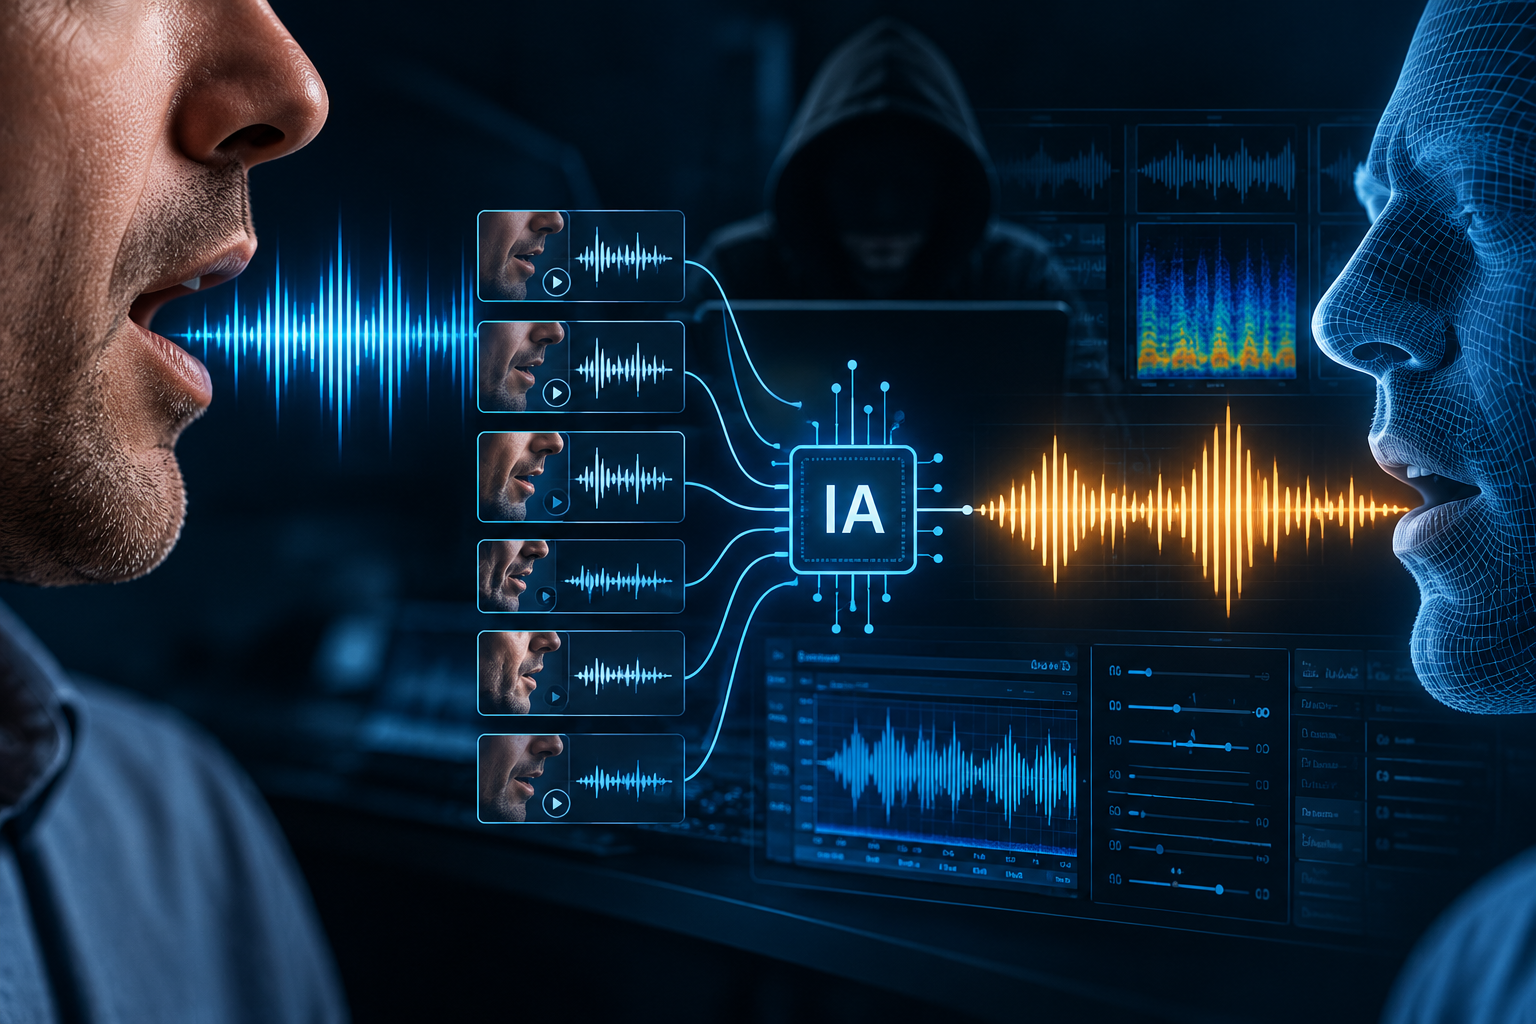
La inteligencia artificial generativa ha cambiado nuestra relación con la evidencia sonora. Una voz reconocible puede transmitir órdenes fraudulentas, fabricar declaraciones comprometedoras, provocar crisis reputacionales o construir grabaciones que aparentan documentar hechos inexistentes. La acústica forense debe diferenciar análisis de identidad vocal, examen de integridad y detección de contenido sintético. Reconocer una voz no equivale necesariamente a demostrar que una persona pronunció las palabras que escuchamos.En la era de la inteligencia artificial, la autenticidad de una grabación no puede darse por supuesta: debe examinarse y sustentarse mediante evidencias técnicas verificables.